Как писать статьи с нейросетью и не попасть под фильтр
Обновлено
11 мин чтения
Коротко
Поисковики не наказывают за сам факт работы с ИИ: под фильтр попадают массовые страницы без пользы и с выдуманными фактами. Чтобы статья прошла проверку, до генерации выпишите свои данные, которых нет у модели, давайте ей подробный бриф, проверяйте цифры, ссылки и метаданные вручную, а после выхода следите за индексированием.

Писать статьи с помощью нейросети можно и для блога компании, и для коммерческого сайта, но поисковики смотрят на результат, а не на инструмент. Под фильтр попадает не текст из ChatGPT или GigaChat сам по себе, а страница без пользы: пересказ выдачи, выдуманные факты, десятки похожих материалов, выпущенных ради трафика.
В этом гайде разберем рабочий порядок: что подготовить до генерации, как ставить задачу модели, где она ошибается чаще всего, что проверить в тексте, метаданных и картинках, с какой скоростью публиковать и по каким признакам в вебмастере и консоли гугла понять, что материал прошел проверку поисковика.
Что поисковики считают нарушением в ИИ-текстах
Гугл наказывает за массовые страницы без добавочной ценности, а сам по себе генеративный сервис нарушением не считается. В руководстве гугла по генеративному контенту сказано, что ИИ можно применять для исследования темы и структуры оригинального материала, а выпуск множества страниц без пользы для людей может нарушать правило о злоупотреблении масштабированным контентом.
Там же гугл ссылается на разделы 4.6.5 и 4.6.6 руководства для асессоров: массовый контент и материалы, сделанные с минимальными усилиями, без оригинальности и без добавленной пользы. Важная деталь: правило описывает цель и результат, а не способ производства. Страница, переписанная человеком из трех чужих статей, попадает в ту же категорию, что и сырой вывод модели.
У яндекса отдельного правила про ИИ-тексты в справке нет, но есть понятный сигнал: статус «Малоценная или маловостребованная страница» в разделе исключенных из поиска. По справке Вебмастера так помечают дубли, страницы без видимого роботу содержимого и страницы, на которые в поиске нет спроса или содержимое которых не вполне отвечает интересам пользователей. Шаблонная статья, повторяющая десять таких же, рискует получить именно этот статус.
До генерации: чего модель не знает о вашей теме
Первый шаг делают без нейросети: выписывают, что в будущей статье будет такого, чего нет у лидеров выдачи и чего модель не возьмет из обучающих данных. Если ответить нечего, генерация даст пересказ, и никакая редактура это не исправит.
Источники такой ценности обычно лежат внутри компании. Подходят собственные данные и расчеты, выгрузки из CRM или аналитики, порядок работы, которого придерживается команда, разбор частых ошибок клиентов, сверка с живой выдачей, официальный документ с адресом. Не подходят общие советы, «объяснение простыми словами» без новых данных и добавление еще одного сгенерированного абзаца в тонкий раздел.
Удобно оформить это как карточку перед каждым материалом. В ней пять строк, и заполнить их стоит до открытия чата с моделью:
- главный вопрос читателя и форма ответа: шаги, сравнение, расчет или выбор;
- два-три факта или наблюдения из своей практики, которые нельзя найти в первой десятке выдачи;
- первоисточники для проверки: документация сервиса, закон, справка поисковика;
- чего в тексте быть не должно: цен, обещаний результата, утверждений без источника;
- чем этот материал отличается от уже опубликованных у вас на ту же тему.
Последняя строка часто оказывается самой полезной. Если тема почти совпадает с прошлой публикацией, лучше дополнить старую страницу, чем выпускать новую: две похожие статьи конкурируют за одни запросы и вместе выглядят как тот самый масштабированный контент. Где искать темы, у которых есть реальный спрос, мы разбирали в статье о том, как находить темы, которые приносят трафик.
Задание для модели и черновик по частям
Хороший черновик получается из подробного брифа и работы по разделам, а не из одной команды «напиши статью на 3000 слов». Короткий запрос возвращает усредненный текст: модель заполняет пробелы самыми частыми формулировками, и статья выходит похожей на сотни других.

Когда задачу ставят как «написать статью нейросетью за пять минут», экономия обычно съедается на вычитке: редактор переписывает половину абзацев и ищет источники для каждой цифры. Написание статьи с помощью нейросети по брифу занимает больше времени на старте, зато правок после него заметно меньше, и текст сразу опирается на ваши факты.
В бриф для генерации переносят карточку ценности и добавляют то, что модель сама не угадает. Порядок, который удобно держать в шаблоне:
- Опишите читателя и его ситуацию одним абзацем: кто он, что уже знает, какое решение принимает.
- Дайте структуру H2 с одной фразой под каждым заголовком: какой ответ раздел должен дать.
- Вставьте свои факты и ссылки на первоисточники прямо в бриф и попросите опираться только на них.
- Перечислите запреты: выдуманные цифры, кейсы, цитаты, названия функций, цены, обещания.
- Просите текст по одному-двум разделам за раз и сразу читайте результат.
Работа по частям нужна не ради объема. Пока раздел короткий, легко заметить, где модель ушла в общие слова или подставила правдоподобную, но непроверенную деталь. В длинном полотне такие места теряются, и редактор пропускает их от усталости.
Полезно также прямо попросить модель помечать места, где она не уверена в факте. Эта просьба не гарантирует честной пометки, зато сокращает число уверенно поданных выдумок. Окончательная проверка все равно остается за человеком.
Проверка фактов: где модель ошибается чаще всего
Ошибки модели сосредоточены в конкретике: цифрах, датах, названиях, ссылках и описаниях функций сервисов. Гугл в том же руководстве объясняет причину: генеративная модель предсказывает вероятную последовательность слов, а не достает факты, поэтому текст нужно вручную проверить перед публикацией.
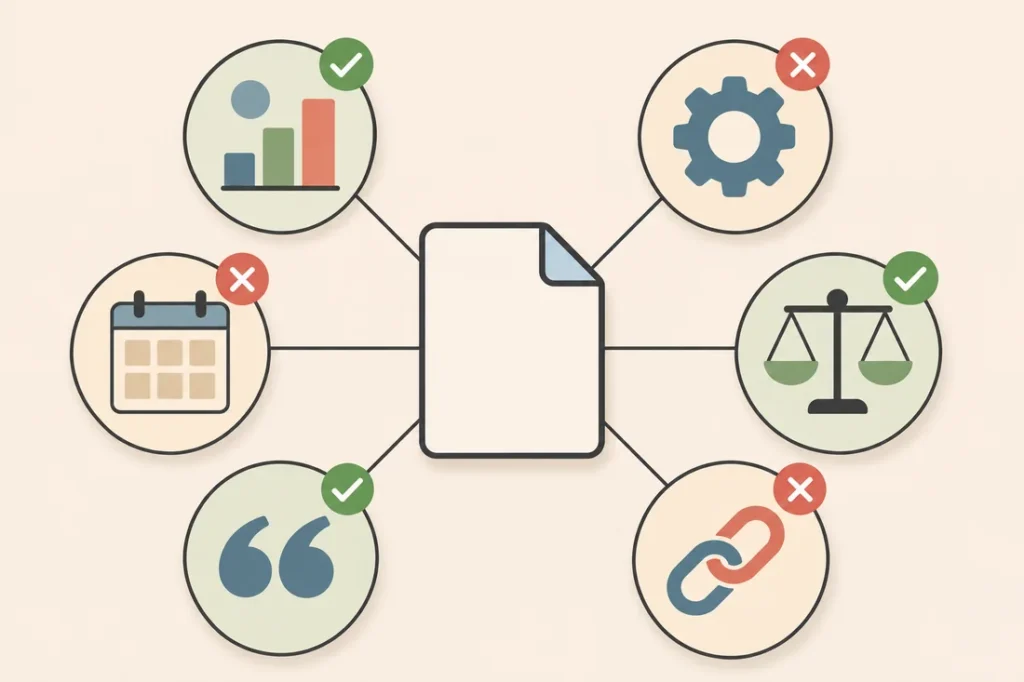
Проверять удобнее по типам утверждений, чем подряд по тексту. Таблица показывает, на что смотреть и чем сверять:
| Тип утверждения | Как обычно ошибается модель | Чем проверить |
|---|---|---|
| Статистика и проценты | приводит правдоподобную цифру без источника или со ссылкой на несуществующее исследование | найти первоисточник; не нашелся, цифру убрать |
| Функции сервисов и настройки | описывает кнопки и отчеты, которых нет или которые переименованы | официальная справка сервиса, свой кабинет |
| Даты, версии, названия обновлений | путает годы и смешивает разные обновления | блог или документация разработчика |
| Законы и нормы | цитирует старую редакцию или выдуманный пункт | действующая редакция на официальном портале |
| Цитаты и мнения экспертов | приписывает слова реальным людям | исходная публикация с датой |
| Ссылки | собирает адрес, который выглядит настоящим, но не открывается | открыть каждую ссылку вручную |
Отдельно ищите сдвиг уверенности. Модель любит превращать «может» в «приводит», а один сценарий в общее правило. Фраза «быстрый сайт поднимает позиции» звучит убедительно, но честнее написать, что скорость входит в число сигналов и влияет вместе с другими. Такие правки занимают минуты и защищают от претензий читателя, который проверит утверждение сам.
Еще одна зона риска касается вашего собственного сайта. Модель может упомянуть услугу, которой у компании нет, назвать неверные сроки работ или сослаться на страницу по выдуманному адресу. Сверяйте такие места со своим сайтом и прайсом, а ссылки на свои страницы ставьте вручную, проверив, что адрес открывается.
Правило для спорных мест простое: факт, который не удалось подтвердить за разумное время, либо убирают, либо формулируют осторожно, с указанием условия. Для тем про деньги, здоровье и право требования строже, там лучше отдать текст на проверку специалисту.
Редактура: следы машинного текста, которые стоит убрать
Читатель и поисковик замечают прежде всего пустоту текста: абзацы, которые ничего не добавляют, одинаковые зачины и обещания без содержания. Редактура начинается с функции каждого абзаца, а стиль идет вторым шагом.
К каждому существенному абзацу задайте два вопроса: что потеряет читатель, если его убрать, и может ли конкурент скопировать его к себе без единой правки. Если ответы «ничего» и «да», абзац переписывают на конкретику или удаляют. Это быстрее и полезнее, чем «очеловечивать» текст заменой слов.
Дальше идут стилистические следы, по которым шаблонный текст узнают с первого экрана: вступления про «современный мир», пустые связки перед каждым выводом, противопоставления по одному шаблону в каждом разделе, три абзаца подряд с одного слова, обилие длинных тире, одинаковые по длине предложения. По отдельности они безобидны, но вместе дают тот самый ровный усредненный тон.
Отдельная задача: сделать текст удобным для цитирования в ответах ИИ-поиска. Прямой ответ в первом предложении каждого раздела, таблицы с конкретикой и самодостаточные абзацы помогают и в обычной выдаче. Подробнее о таком построении мы писали в материале о том, как написать текст, который нейросеть захочет процитировать.
Title, description, alt и разметка тоже проходят проверку
Метаданные проверяют так же внимательно, как текст: в руководстве гугла прямо перечислены title, meta description, структурированные данные и alt картинок. Они попадают в выдачу, и ошибка в них видна раньше, чем человек откроет страницу.
Чаще всего в сгенерированных метаданных встречаются цифры, которых нет в тексте, обещания вроде «гарантированный результат» и описание, которое пересказывает заголовок другими словами. Проверка короткая: каждая цифра из title и description должна встречаться в статье, каждое утверждение должно подтверждаться текстом, а вопросы в разметке FAQ должны дословно совпадать с видимыми на странице.
С картинками риск похожий. Alt, который сгенерирован списком ключей, бесполезен для человека с экранным диктором и похож на переоптимизацию. Хороший alt описывает сцену в одном предложении. Если иллюстрации тоже сделаны генеративным сервисом, гугл советует сообщать об этом через метаданные изображения, а для интернет-магазинов метка IPTC обязательна. Как получить картинки без текста-каши и артефактов, разобрано в статье о том, как создавать изображения для сайта с нейросетью.
Публикация серией: темп и похожесть страниц
Безопасного числа статей в день не существует: правило гугла про масштабированный контент оценивает пользу каждой страницы, а не скорость выпуска. Риск растет, когда много материалов выходит по одному шаблону и отличается только темой в заголовке.
Если статьи с помощью нейросети выходят регулярно, темп стоит подбирать под возможности проверки, а не под возможности генерации. Модель выдаст десять черновиков за вечер, но если команда успевает внимательно проверить два, публиковать разумно два. Остальные черновики подождут: устаревают они медленнее, чем репутация сайта после серии ошибок.
Поэтому в серии полезно проверять не только отдельную статью, но и похожесть статей между собой. Мы смотрим, с каких слов начинаются заголовки разделов и вопросы FAQ во всех материалах блога: если одно и то же начало стоит у трети страниц, это шаблон, который заметит и читатель, и алгоритм. То же касается первого абзаца, одинаковых блоков советов и повторяющихся вопросов в конце.
Вторая проверка касается дословных совпадений с уже опубликованными страницами сайта. Модель охотно повторяет удачные фразы из соседних материалов, если они попали в бриф, и через несколько месяцев блог начинает конкурировать сам с собой. Сравнивайте новый текст с корпусом своих статей до публикации, а не после.
Наконец, решите, кто читает тексты целиком. При регулярной публикации разумно, чтобы человек полностью вычитывал хотя бы часть материалов, например каждый десятый, а по остальным проверял факты, ссылки и метаданные. Так ошибки шаблона ловятся раньше, чем расходятся на десятки страниц.
После публикации: какие признаки смотреть в вебмастере и консоли
Понять, что страница не прошла оценку поисковика, можно по индексированию в первые недели: исключение из поиска или долгий статус «не проиндексировано» говорит об этом раньше, чем падение трафика. Смотреть стоит в двух местах.
В Яндекс Вебмастере откройте исключенные страницы и найдите новые адреса со статусом «Малоценная или маловостребованная». Одна такая статья еще не повод для тревоги, но если статус получает заметная часть серии, проблема в шаблоне, а не в отдельном тексте. В консоли гугла полезен отчет об индексировании страниц: статус «Страница просканирована, но пока не проиндексирована» у многих новых статей подряд часто говорит о том, что поисковик не нашел в них достаточной ценности, хотя бывают и технические причины, например слабая перелинковка на новые адреса. Если вы только осваиваете этот отчет, начните с инструкции о главных отчетах гугл серч консоли.
Для каждой статьи серии через две-три недели после выхода записывайте четыре вещи: попала ли она в индекс обоих поисковиков, есть ли показы в поиске, какие запросы она получила, совпадают ли они с задуманными. Если статьи индексируются, но не получают показов, причина чаще в выборе темы. Если не индексируются, причина в качестве или похожести, и следующий шаг здесь: доработать шаблон, а не выпускать новые страницы тем же способом.
Итог: порядок работы и следующий шаг
Схема, которая снижает риск фильтров, укладывается в шесть действий: карточка ценности до генерации, подробный бриф, черновик по разделам, проверка фактов по типам утверждений, редактура по функции абзацев, проверка метаданных и наблюдение за индексированием после выхода. Нейросеть в ней ускоряет черновую работу, а ценность и ответственность за факты остаются у людей.
Начать можно с одной статьи: заполните для нее карточку из пяти строк и посмотрите, найдется ли хотя бы два своих факта или наблюдения. Если находится, у материала есть шанс выделиться в выдаче. Если нет, сначала стоит поменять угол темы, а уже потом открывать чат с моделью.
Если хочется выстроить такой процесс для блога целиком, с планом тем, брифами, проверкой и замером результата, можно обсудить контент-маркетинг для SEO под ваш проект: посмотрим, какие темы дадут спрос, и предложим порядок работы с ИИ без риска для сайта.
Частые вопросы
Можно ли написать статью нейросетью онлайн бесплатно?
Да, у большинства популярных чат-ботов есть бесплатный режим с ограничениями по числу запросов или по версии модели. Для черновика этого обычно хватает. Ограничение в другом: бесплатный сервис не знает ваших данных и не проверяет факты, поэтому бриф, свои наблюдения и вычитку перед публикацией все равно придется делать самому.
Можно ли сделать рерайт чужой статьи через ИИ?
Технически да, но для поиска такой текст почти ничего не стоит. Пересказ чужого материала без новых данных гугл относит к контенту с минимальной добавленной пользой, независимо от того, переписал его человек или модель. Полезнее взять чужую статью как один из источников и добавить к теме свои факты, примеры и выводы.
Определяет ли гугл, что текст написан ИИ?
Гугл не сообщает о таком механизме и в своей документации оценивает не способ создания, а пользу страницы. Сам факт работы с генеративным сервисом правил не нарушает. Нарушением считается выпуск множества страниц без ценности для людей, поэтому важнее проверить текст на выдумки и пустые абзацы, чем пытаться обмануть детекторы.
Нужно ли помечать, что материал помогал писать ИИ?
Обязательной метки для статей в поиске нет, но гугл советует рассказывать, как создан контент, там, где читатель этого ожидает. Для интернет-магазинов правила строже: описания товаров, созданные ИИ, в Merchant Center отмечаются отдельно, а у сгенерированных картинок должна быть метка в метаданных IPTC.
Сколько текстов в день публиковать без риска санкций?
Безопасного числа нет: правило о масштабированном контенте оценивает пользу каждой страницы, а не темп выпуска. Две полезные статьи в день не нарушают правил, а десять одинаковых по шаблону могут. Ориентируйтесь на то, успеваете ли вы проверить факты, ссылки и метаданные у каждой статьи до публикации.


